Resposta rápida
S agressivo é a reclamação mais comum sobre locução gravada em casa, e uma das mais fáceis de piorar: um conserto exagerado deixa a pessoa com som de língua presa. Este guia mostra como diferenciar sibilância de uma voz simplesmente brilhante, por que ela acontece, como o de-esser do nosso editor decide quando agir e o que ele mediu num arquivo de teste.
Como reconhecer a sibilância
Sibilância não é o mesmo que voz brilhante. Uma voz brilhante soa nítida o tempo todo; uma voz sibilante soa bem até chegar um S, X, Z ou C suave, e aí um chiado curto e penetrante salta. Fica mais evidente no fone, em frases com vários S seguidos ("o sapo sabe se o sol se pôs") e depois da compressão, que sobe as partes baixas e os S junto.
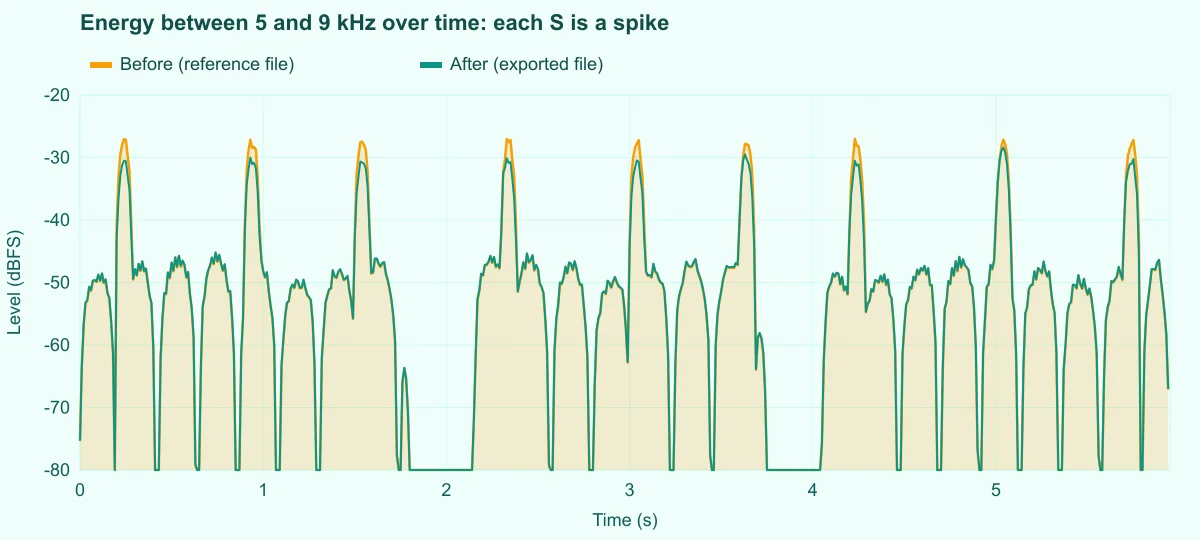
No português, com tantos plurais terminados em S e o "chiado" carioca no fim das sílabas, a sibilância aparece ainda mais que no inglês. Numa forma de onda comum ela não aparece, porque o chiado é baixo perto das vogais. Fica clara quando você olha só a faixa de 5 a 9 kHz ao longo do tempo, como na Figura 2: cada S é um pico que sobe 15 a 20 dB acima do resto da fala nessa faixa.
Por que a sibilância acontece
S e X são feitos empurrando ar por uma fresta estreita entre a língua e os dentes. A turbulência gera um ruído com quase toda a energia no agudo: algo entre 4 e 6 kHz em vozes mais graves e entre 6 e 9 kHz nas mais agudas. Várias coisas fazem ela se destacar na gravação:
- Microfones com pico de presença. Muitos microfones USB e condensadores reforçam 5 a 10 kHz para soar claros, o que também reforça o S.
- Falar de frente para a cápsula. Agudos são muito direcionais. Virar o microfone um pouco para longe da boca suaviza o S mais do que qualquer coisa feita depois.
- Compressão e processamento de loudness. Eles sobem o nível médio, e os S curtos sobem junto.
- Reforço de "ar" no equalizador. Um shelf agudo para dar clareza levanta a faixa do S também.
Um corte fixo no equalizador em 6 ou 7 kHz reduziria o S, mas também abafaria todas as outras consoantes e a respiração natural da voz durante a gravação inteira. O de-esser corta só quando acontece um S.
Como o de-esser decide quando agir
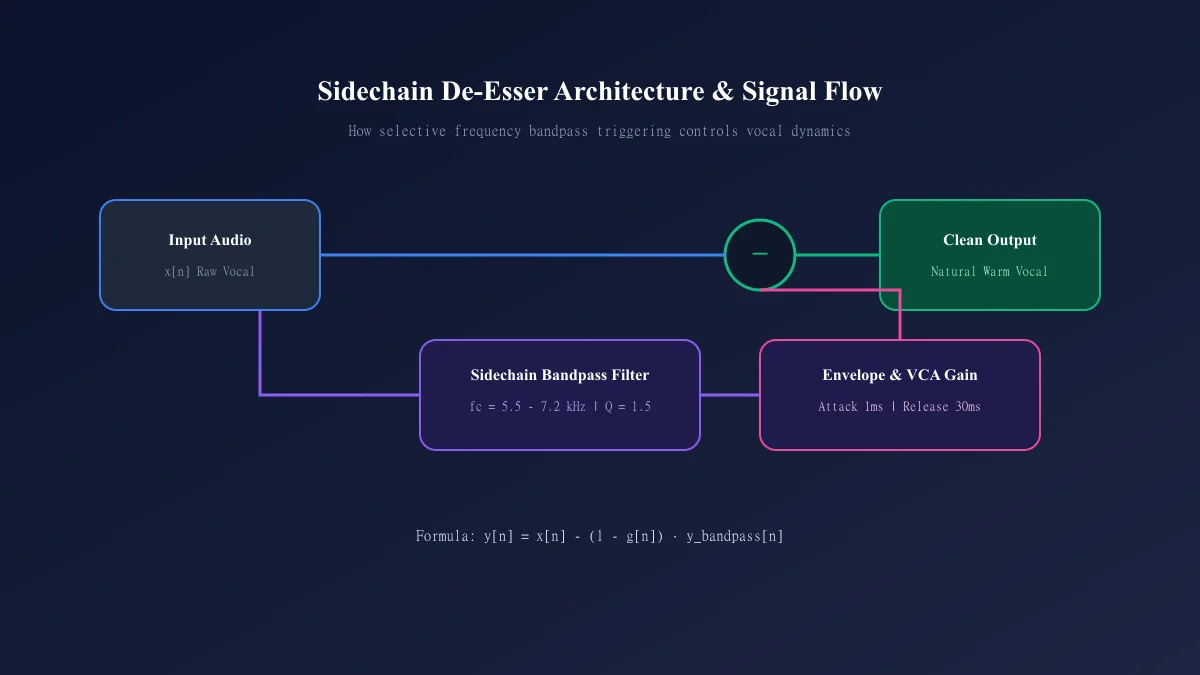
O de-esser passa a voz por um filtro passa-banda (Q de 1,5) centrado no perfil vocal escolhido: 5,5 kHz para vozes mais graves, 7,2 kHz para as mais brilhantes. Ele acompanha o nível dessa faixa com um envelope rápido, 1 ms para reagir e 30 ms para soltar, e compara com o nível do sinal inteiro. Só age quando duas coisas são verdade: a faixa está acima do limiar de detecção e carrega mais de cerca de um terço da energia naquele instante. As vogais não passam no segundo teste, então seguem intactas.
Quando age, ele subtrai parte da faixa da voz: saída = entrada − (1 − ganho) × faixa. O corte cresce conforme o S domina, até 20 dB × a intensidade. Nos 50% do preset Equilibrado o máximo que ele tira é 10 dB, e S típicos recebem menos, por isso a média medida fica em alguns decibéis.
Como tirar a sibilância, passo a passo
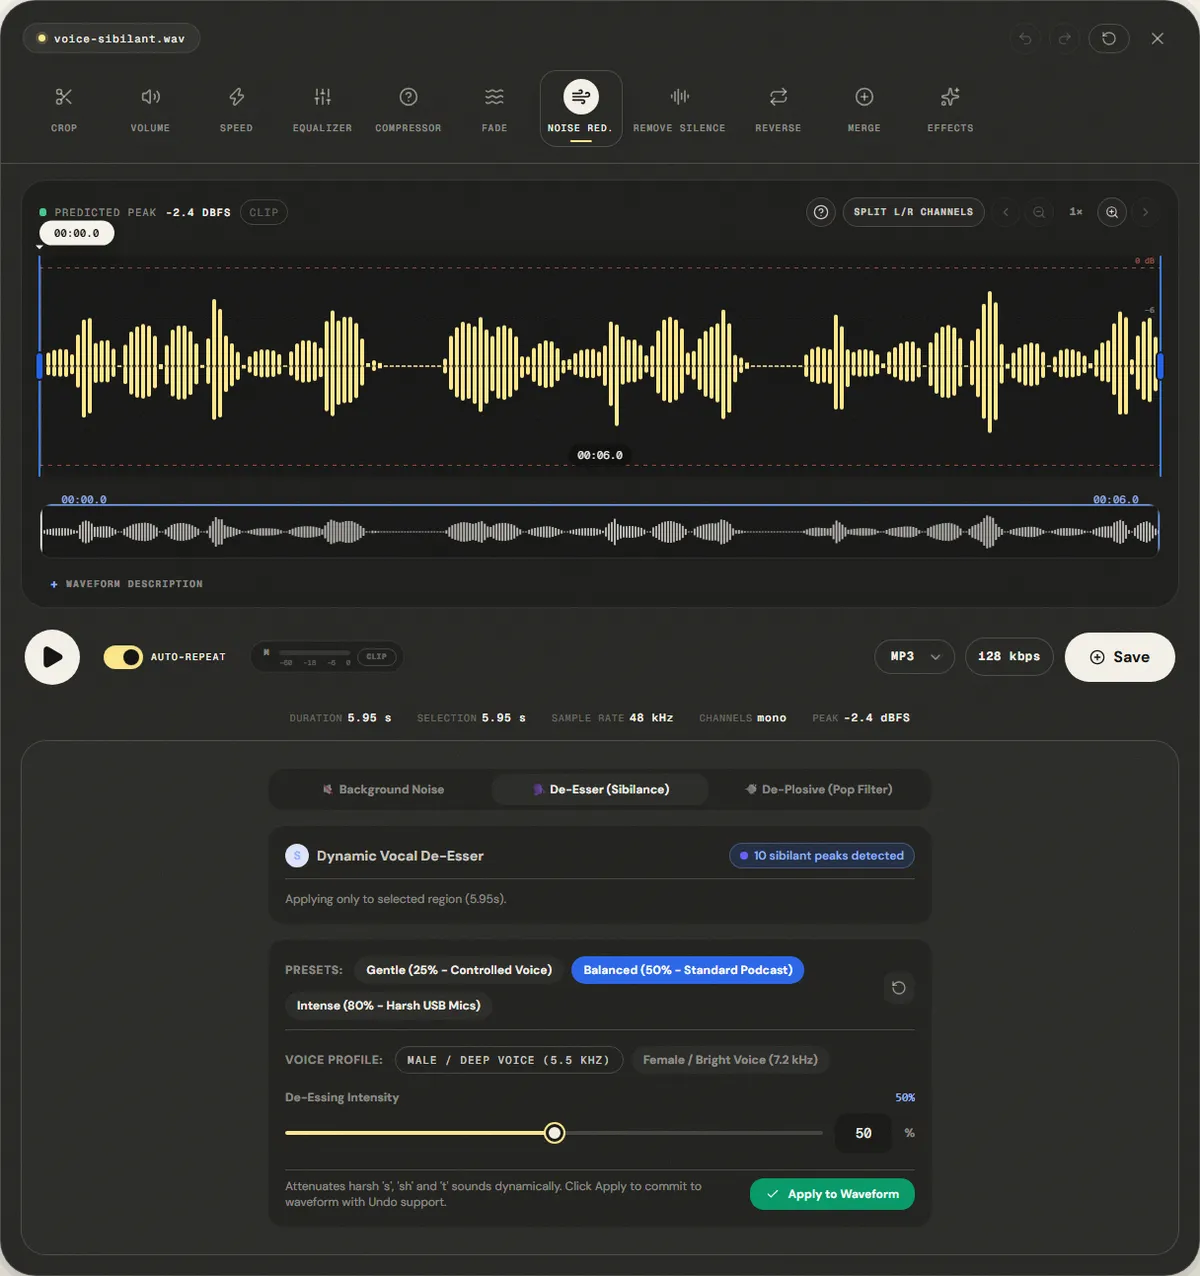
A página De-Esser abre o arquivo no editor, nas ferramentas de ruído, com a aba De-Esser (Sons de S) já escolhida. Roda no seu navegador.
Passo 1: Abra o arquivo e confira a contagem
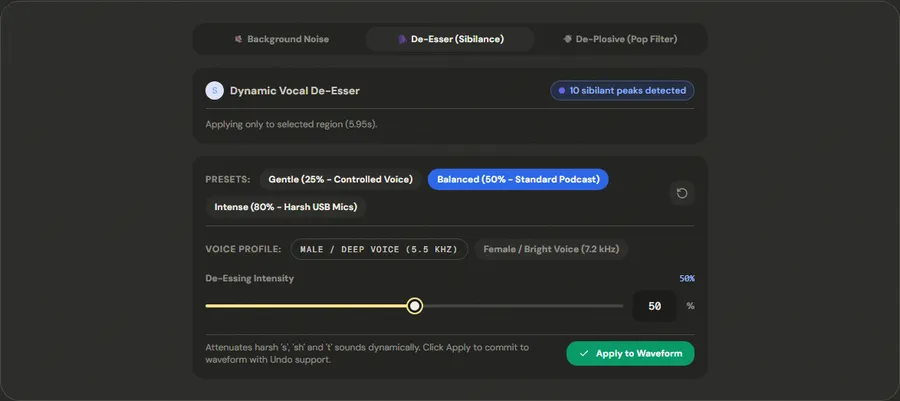
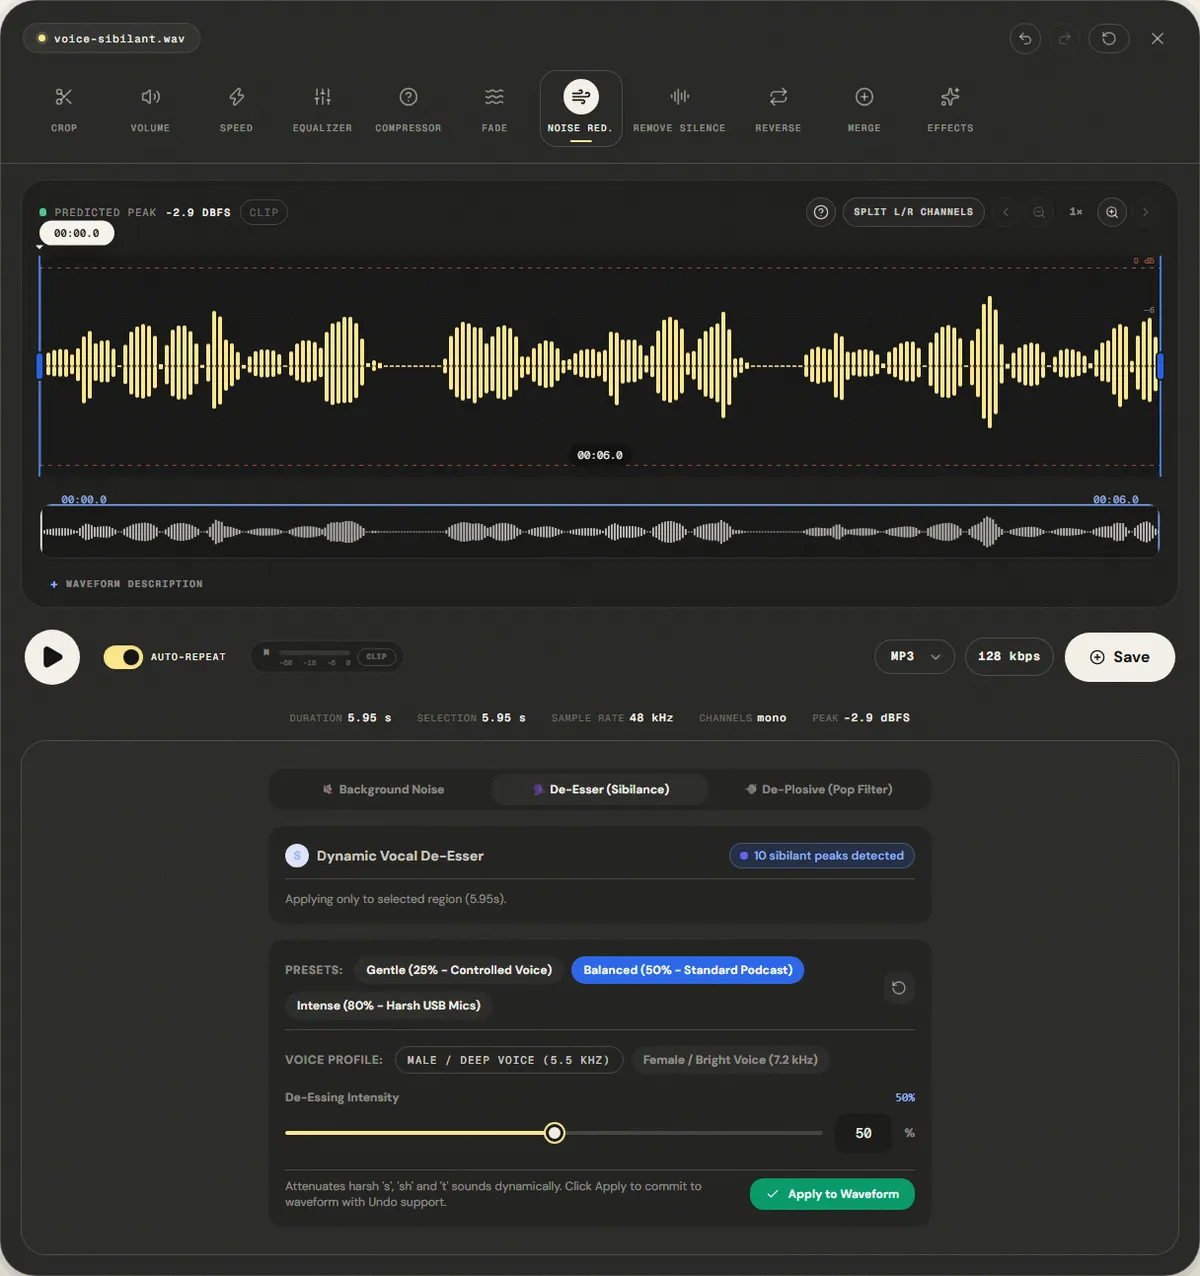
O cartão no alto, De-Esser Vocal Dinâmico, mostra quantos picos sibilantes a análise achou; no nosso arquivo apareceu "10 picos sibilantes detectados" para nove S inseridos. A linha abaixo diz qual trecho será processado. Para limitar o de-esser a uma parte do arquivo, selecione-a na forma de onda antes.
Passo 2: Escolha uma predefinição e um perfil vocal
- Suave (25% - Locução Controlada): para uma voz quase boa, com alguns S mais agudos.
- Equilibrado (50% - Padrão Podcast): o padrão, e o que medimos.
- Intenso (80% - Microfones USB/Brilhantes): para microfones brilhantes em que o S incomoda em volume normal.
Depois escolha Voz Masculina / Grave (5,5 kHz) ou Voz Feminina / Aguda (7,2 kHz). Os nomes são um atalho, não uma regra: uma voz feminina grave pode ficar melhor em 5,5 kHz e uma masculina brilhante em 7,2 kHz. Escolha o perfil que deixa o S mais baixo na mesma intensidade. Intensidade do De-Esser faz o ajuste fino de 0 a 100%.
Passo 3: Ouça e aplique
Toque uma frase cheia de S no fone, no volume que o seu público vai usar. O S deve parar de incomodar, mas continuar soando como S. Depois clique em Aplicar na Forma de Onda. A forma de onda é atualizada e dá para desfazer, então teste dois ajustes seguidos se tiver dúvida.
Passo 4: Depois comprima e exporte
Use o de-esser antes do compressor e antes de normalizar. Os dois sobem as partes baixas da voz; se os S ainda estiverem altos nesse ponto, sobem junto com o resto. Exporte pelo editor quando a sequência estiver pronta.
Exemplo medido
Adicionamos nove rajadas de ruído centradas em 6,5 kHz, com a duração de um S, à voz de referência. A página abriu o editor na aba De-Esser; clicamos em Aplicar na Forma de Onda com o preset padrão Equilibrado e o perfil de voz de 5,5 kHz.
A energia na faixa de sibilância, de 5 a 9 kHz, caiu 3,2 dB, enquanto a faixa da fala, de 300 Hz a 3,4 kHz, variou +0,2 dB.
| Medida | Antes | Depois |
|---|---|---|
| Faixa de sibilância 5–9 kHz | 26,8 dB | 23,6 dB |
| Faixa da fala 300 Hz–3,4 kHz | 34,7 dB | 34,9 dB |
Arquivo de referência (antes)
Arquivo exportado (depois)
O Equilibrado é moderado de propósito, para os S ficarem mais macios sem som de língua presa. Para gravações mais agressivas, o preset Intenso ou o perfil de 7,2 kHz reduzem mais; ouça se não ficou com língua presa a cada mudança.
Baixar o arquivo de referência (WAV) · O mesmo teste na página da ferramenta · Medido em 11 de novembro de 2026
O resultado é moderado de propósito. O Equilibrado baixou a faixa do S em 3,2 dB na média e cada pico de S em cerca de 3 a 4 dB, sem mexer nas vogais. É o bastante para tirar o incômodo de uma sibilância normal. Para uma voz em que os S estão 10 dB altos demais, o Intenso ou o outro perfil vocal vão mais longe, e é aí que começa o risco de língua presa; compare cada passo no ouvido.
Solução de problemas
| O que você ouve ou vê | Causa provável | O que mudar |
|---|---|---|
| Os S ainda furam o ouvido | Intensidade baixa, ou o S fica acima ou abaixo do perfil escolhido | Teste o Intenso, ou troque o perfil vocal |
| A voz ficou com língua presa ou o S virou um som de “th” | Redução demais | Desfaça e use o Suave ou uma intensidade menor |
| A voz inteira ficou mais abafada | Chiado constante, não sibilância | Use a redução de ruído de fundo, ou um corte suave no equalizador |
| Pratos e chimbal da música ficaram mais baixos | Eles dividem a faixa com o S | Use o de-esser só na faixa de voz, ou selecione só os trechos falados |
| A sibilância piorou depois da compressão | A compressão veio antes | Use o de-esser antes de comprimir e normalizar |
Limites e alternativas
Um de-esser reduz sibilância; ele não corrige um microfone agressivo em todas as frequências nem uma gravação cheia de chiado. Também não diferencia um S de um prato: numa música mixada ele abaixa os dois. Plugins dedicados acrescentam modo de banda dividida, look-ahead e rastreamento de frequência que acompanha cada S; esta ferramenta usa uma faixa fixa por perfil vocal e reage em tempo real, sem olhar à frente.
A maior melhora vem antes da gravação. Incline o microfone 15 a 30 graus para fora da boca, ou aponte para o queixo, e mantenha a distância de um palmo. Uma espuma de microfone faz pouco pelo S; ângulo e distância fazem quase todo o trabalho.
Perguntas frequentes
Em que frequência fica a sibilância?
Quanto reduzir?
Uso o de-esser antes ou depois da compressão?
Dá para usar o de-esser numa música inteira?
O de-esser é a mesma coisa que um filtro passa-baixas?
Fontes e como isto foi testado
- Robert Bristow-Johnson, Audio EQ Cookbook (nota do W3C): filtro passa-banda e Q, em inglês
- MDN: BiquadFilterNode
Testado em 11 de novembro de 2026 no Chromium 153 com Windows 11, numa build de produção deste site. As capturas e medições foram feitas pelos scripts em scripts/tool-evidence, a partir de arquivos de referência sintéticos que qualquer pessoa pode baixar e repetir.