Ducking Dinâmico por Sidechain · Atenuação Automática da Música e Repetição em Loop
Adicionar Música de Fundo com Auto-Ducking — Mixador para Voz e Podcast
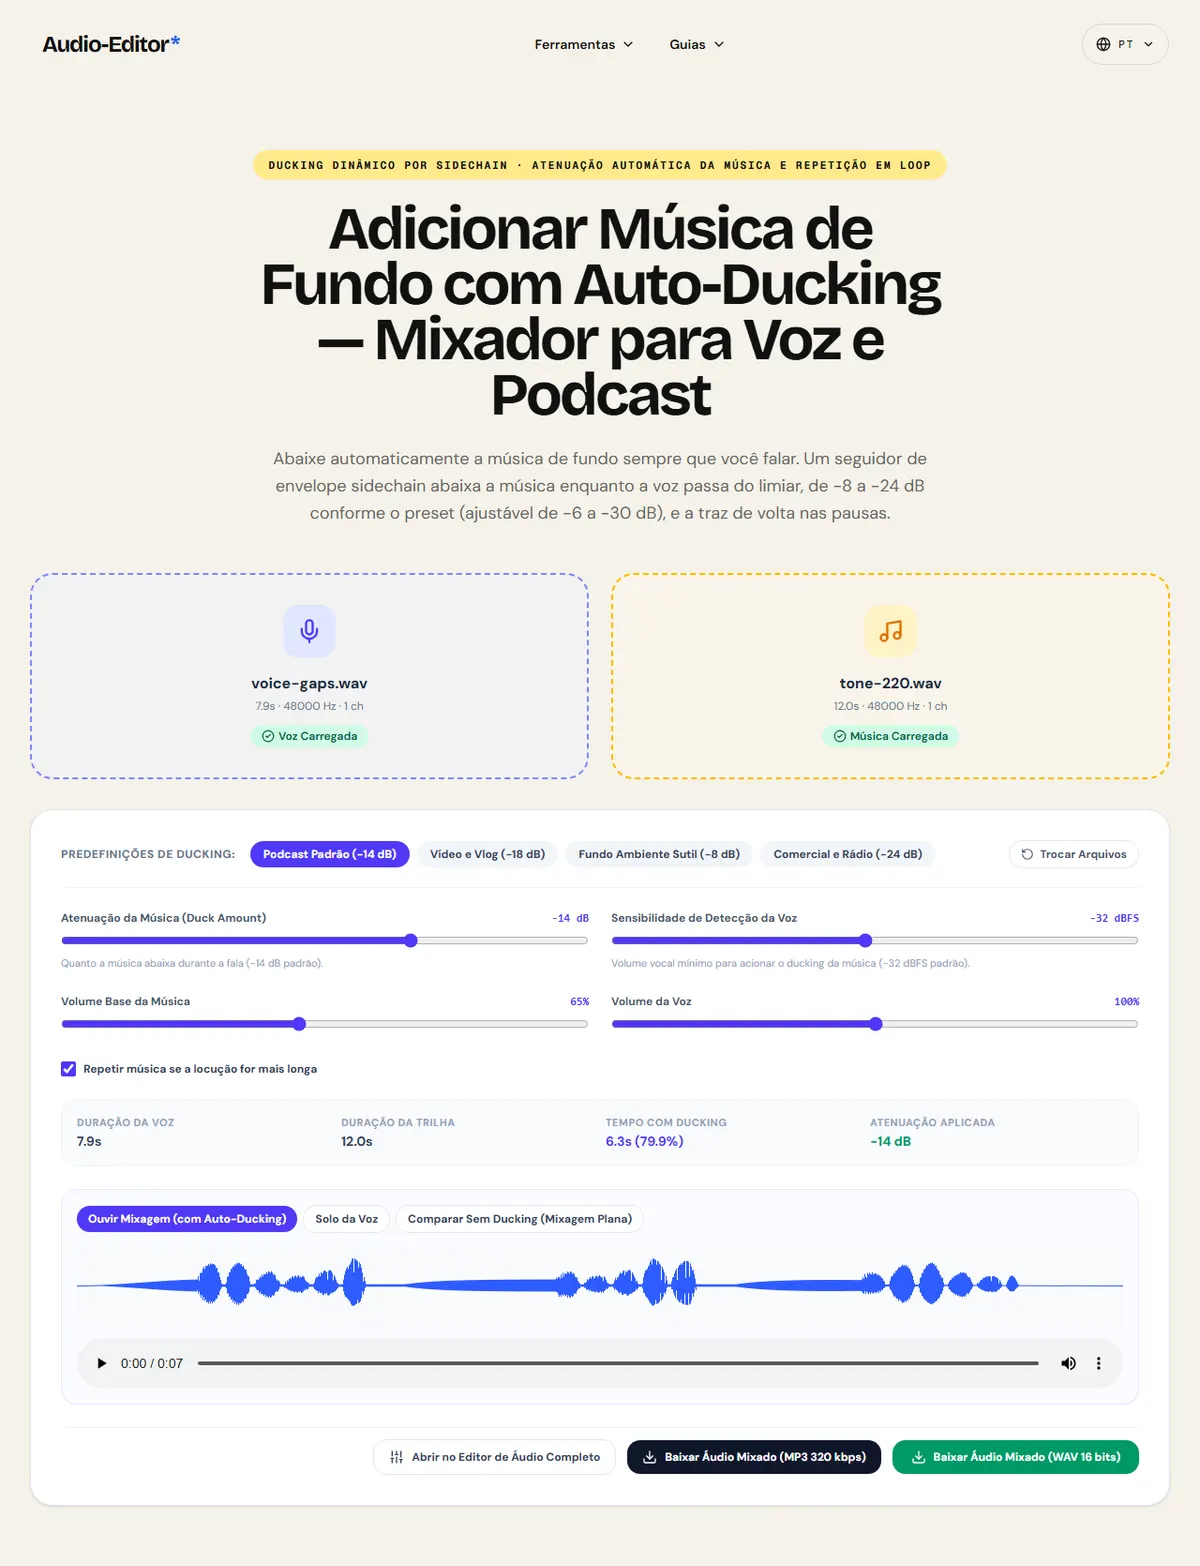
Abaixe automaticamente a música de fundo sempre que você falar. Um seguidor de envelope sidechain abaixa a música enquanto a voz passa do limiar, de −8 a −24 dB conforme o preset (ajustável de −6 a −30 dB), e a traz de volta nas pausas.
Carregar Faixa de Voz / Locução (Áudio Principal)
Selecione a gravação de podcast, narração, aula ou locução (MP3, WAV, M4A, FLAC, OGG).
Carregar Trilha de Música de Fundo (Áudio Secundário)
Selecione a trilha sonora instrumental ou tema musical para tocar sob a locução.
Rastreamento por Sidechain
Monitora a energia da voz em janelas RMS móveis e abaixa a música em 40 ms sempre que a fala começa.
Zero Bombeamento / Pumping
Tempo de retenção (hold) calibrado de 300 ms e curva suave de relaxamento evitam oscilações entre sílabas.
Loop Inteligente da Trilha
Repete músicas mais curtas perfeitamente ao longo de falas longas com microfades anti-estalo nas emendas.
Por Que a Inteligibilidade da Fala Exige Ducking Dinâmico
O Dilemma do Mascaramento Acústico na Mixagem de Voz e Música
Quando voz falada e música instrumental tocam simultaneamente, a energia dos instrumentos musicais (especialmente guitarras, teclados, pianos e caixas) compete diretamente com as frequências formantes da voz humana entre 1 kHz e 4 kHz. Devido ao fenômeno psicoacústico do mascaramento auditivo, o cérebro tem dificuldade para discernir fonemas rápidos, tornando a fala embolada e cansativa.
Abaixar a música estaticamente em -18 dB durante toda a gravação garante clareza durante a fala, mas cria vazios acústicos frios durante pausas naturais, transições de parágrafos e respirações. O ouvinte percebe essa falta de dinâmica como amadora e desinteressante.
Como o Auto-Ducking por Sidechain Opera Sem Bombeamento Indesejado
O auto-ducking resolve esse problema de forma dinâmica e automatizada. A faixa de voz atua como chave de controle por sidechain: um seguidor de envelope RMS monitora continuamente a energia da voz em janelas de 15 ms. Quando a voz ultrapassa o limiar (ex.: -32 dBFS), uma curva logarítmica de ataque atenua a música em cerca de 40 ms.
Crucialmente, para evitar o efeito de 'bombeamento' (pumping), em que o volume da música oscila descontroladamente entre sílabas curtas, um tempo de retenção (Hold de 250 a 350 ms) mantém a trilha baixa durante toda a frase. Apenas quando uma pausa real de fala ocorre é que o tempo de relaxamento (Release de 500 a 800 ms) eleva a música com suavidade.
Repetição em Loop sem Costuras e Fades de Borda em Potência Igual
Em podcasts e narrações, a gravação da voz frequentemente dura vários minutos, enquanto trilhas sonoras instrumentais duram apenas de 30 a 90 segundos. Este motor repete a música em loop de forma contínua ao longo de toda a linha do tempo da voz, aplicando microfades anti-clique nas junções.
No início e no encerramento da mixagem, envelopes em curva S (raised-cosine) introduzem a música com elegância e realizam um fade-out suave de 2,5 segundos após o término da fala, evitando cortes secos.
Como Adicionar Música com Auto-Ducking em 3 Passos
Passo 1: Carregue a Faixa de Voz e a Trilha de Música
Envie sua gravação de voz no slot principal e seu arquivo de música instrumental no slot secundário. Suporta MP3, WAV, M4A, AAC e FLAC.
Passo 2: Escolha uma Predefinição Calibrada
Selecione 'Podcast Padrão' (corte de -14 dB) para entrevistas, 'Vídeo e Vlog' (corte de -18 dB) para trilhas marcantes ou 'Fundo Sutil' (-8 dB) para acústicos.
Passo 3: Ouça a Prévia A/B e Baixe a Mixagem Pronta
Ouça a mixagem com ducking dinâmico versus a versão sem ducking. Exporte diretamente como WAV de 16 bits sem perdas ou MP3 em alta taxa de bits.
Perguntas Frequentes Sobre Auto-Ducking
O que é auto-ducking na produção de áudio?
Auto-ducking é um processo automatizado de mixagem por sidechain no qual o volume da trilha secundária (como música de fundo) abaixa automaticamente quando a faixa principal (voz ou apresentador) está falando, retornando ao volume nominal durante as pausas.
Qual profundidade de ducking (dB) é recomendada para podcasts?
Para podcasts tradicionais, uma atenuação de música entre -12 dB e -15 dB é ideal. Isso libera espaço espectral para a voz sem fazer a música sumir. Para trilhas de pop ou eletrônica com muita densidade, cortes entre -18 dB e -22 dB garantem inteligibilidade total.
O que acontece se a música for mais curta que a gravação da voz?
Por padrão, o motor repete a música em loop de forma contínua durante toda a duração da voz, com microfades nas junções para evitar cliques, e encerra com um fade-out musical de 2,5 segundos no final.
O auto-ducking envia minha voz ou música para servidores externos?
Não. Toda a análise RMS, rastreamento de envelope, repetição em loop e mixagem multicanal são executados localmente no seu navegador através da Web Audio API. Seus arquivos nunca saem do seu computador.
( Guia prático )
Ajustando música sob uma voz
O ducking abaixa a música automaticamente enquanto alguém fala e a traz de volta nas pausas. A ferramenta acompanha o nível da faixa de voz: quando ele passa do limiar, a música desce pelo valor do ducking durante o tempo de ataque, se mantém enquanto a voz continua e volta durante o tempo de liberação.
Qual preset para cada conteúdo
| Podcast de entrevista ou conversa | Podcast Padrão: −14 dB, limiar −32 dBFS |
|---|---|
| Vlog ou vídeo com trilha movimentada | Vídeo e Vlog: −18 dB, ataque mais rápido (35 ms) |
| Meditação ou lo-fi, a música deve continuar presente | Fundo Ambiente Sutil: −8 dB |
| Promo estilo rádio com trilha alta | Comercial e Rádio: −24 dB |
Exemplo: um tutorial de 3 minutos com um loop de música de 1 minuto
- Carregue a narração como faixa de voz e o loop como música; com a repetição ligada, a música se repete até cobrir os 3 minutos.
- Comece com Podcast Padrão. Se respirações ou ruído de sala mantiverem a música baixa nas pausas, suba o limiar para perto de −28 dBFS.
- Compare a mixagem com ducking com a versão sem ducking e depois exporte.
A música fica cerca de 14 dB abaixo da narração enquanto ela toca e volta em cerca de 0,6 s em cada pausa.
Limites
- O ducking segue o nível, não as palavras: ruído alto na faixa de voz também abaixa a música.
- Só uma faixa de voz e uma de música são mixadas; não há linha do tempo para posicionar vários trechos.
- Use música com direitos de uso. O ducking não muda licenciamento nem correspondências do Content ID.
( Medido num arquivo de referência )
Quanto a música abaixa enquanto alguém fala
Para ler o nível da música dentro da mixagem, usamos um tom constante de 220 Hz como "música" e a nossa voz de referência com pausas longas como faixa de voz, mixadas com o preset padrão Podcast Padrão (−14 dB).
Nas pausas a música ficou em cerca de -16,4 dBFS; enquanto a voz falava ela caiu para cerca de -34,2 dBFS, 17,9 dB abaixo em média.
A queda medida passa dos 14 dB do preset em algumas frases, porque a leitura inclui o tempo que a música leva para voltar. Pausas menores que cerca de um segundo não deixam ela se recuperar totalmente.
| Medida | Nas pausas | Durante a fala |
|---|---|---|
| Nível da música (tom de 220 Hz) | -16,4 dBFS | -34,2 dBFS |
Baixar o arquivo de referência (WAV)Os arquivos de referência são sintetizados pelo próprio site (sinais parecidos com fala e com música), para qualquer pessoa repetir o teste. Medido em nesta página, baixando o WAV mixado. Como medimos
( Notas de campo )
Ducking por sidechain e trilha de fundo
Como o ducking automático por sidechain mantém a voz nítida sobre trilhas sonoras.
- ( 01 ) · 13 min de leitura
Como Juntar Áudios sem Saltos de Volume, Silêncios ou Cliques
Ler - ( 02 ) · 14 min de leitura
Guia de LUFS para Podcast, YouTube, Aulas e Música
Ler - ( 03 ) · 15 min de leitura
Como Equalizar Voz, Música e Podcast Online
Ler